Что такое модель машинного обучения?
Моделью машинного обучения называется файл, который обучен распознаванию определенных типов закономерностей. Вы обучаете модель на основе набора данных, предоставляя ей алгоритм, который она может использовать для анализа и обучения на основе этих данных.
Завершив обучение модели, вы сможете применить ее для принятия решений и выполнения прогнозов по данным, которые ранее не встречались. Предположим, вам нужно создать приложение для распознавания эмоций пользователя по его выражению лица. Вы можете обучить модель по набору изображений лиц, каждое из которых отмечено тегом определенной эмоции, а затем применить эту модель в приложении для распознавания эмоций пользователя. Примером такого приложения служит Emoji8.
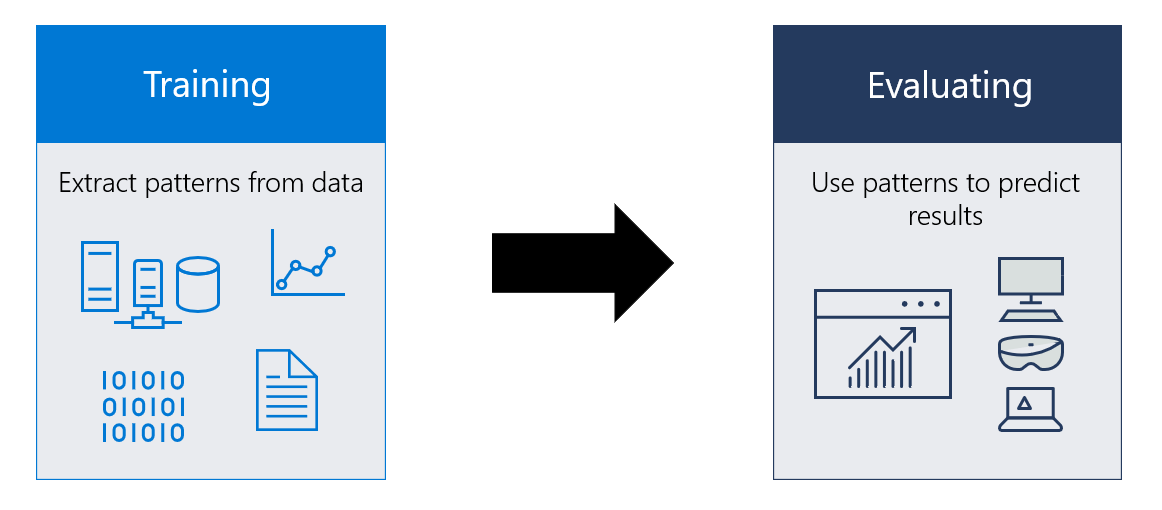
Когда использовать Машинное обучение
Продуманные сценарии машинного обучения обычно имеют следующие общие свойства:
- Они предполагают периодическое принятие решений или оценку, которую необходимо автоматизировать для получения согласованных результатов.
- Явно описать схему или критерии при принятии решения очень сложно или невозможно.
- У вас есть помеченные данные или существующие примеры, в которых вы можете описать ситуацию и сопоставить ее с правильным результатом.
Windows Machine Learning использует для своих моделей формат ONNX (Open Neural Network Exchange). Вы можете скачать предварительно обученную модель или обучить собственную. Дополнительные сведения о получении моделей ONNX для Windows ML см. в этой статье.
Начало работы
Вы можете начать работу с Windows Machine Learning, пройдя один из наших учебников или сразу перейдя к примерам Windows Machine Learning.
Используйте следующие ресурсы для получения справки по машинному обучению в Windows:
- Чтобы задать технические вопросы о машинном обучении в Windows или ответить на них, используйте тег windows-machine-learning в Stack Overflow.
- Сообщить об ошибке можно в нашем репозитории GitHub.
Модели машинного обучения: объясняем пятилетнему ребенку
Специалисты компании Sociaro подготовили перевод очередной статьи, которая поможет разобраться в том, что такое Машинное обучение.
Статья Megan Dibble с Medium Towards Data Science это максимально простое объяснение работы ML моделей.
Если вы новичок в data science, заголовок не был направлен на то, чтобы вас обидеть. Это мой второй пост на тему популярного вопроса на интервью, который звучит примерно так: «объясните мне [вставить техническую тему], как вы бы объяснили пятилетнему ребенку.»
Выходит, достичь уровня понимания пятилетнего ребенка довольно сложно. Так что, хоть эта статья может быть не совсем ясна детсадовцу, она будет понятна тому, кто практически не имеет опыта в data science (и если вы поймете, что это не так, пожалуйста, напишите об этом в комментариях).
Я начну с объяснения понятия машинного обучения, а также его различных типов, а затем перейду к объяснению простых моделей. Я не буду особо вдаваться в математику, но подумываю сделать это в своих будущих статьях. Наслаждайтесь!
Определение Машинного Обучения
Illustration of Machine Learning
Машинное обучение – это когда вы загружаете большое количество данных в компьютерную программу и выбираете модель, которая «подгонит» эти данные так, чтобы компьютер (без вашей помощи) мог придумывать прогнозы. Компьютер строит модели, используя алгоритмы, которые варьируются от простых уравнений (например, уравнение прямой) до очень сложных систем логики/математики, которые позволяют компьютеру сделать самые лучшие прогнозы.
Название – машинное обучение — очень удачное, потому что как только вы выбираете модель, которую будете использовать и настраивать (другими словами, улучшать с помощью корректировок), машина будет пользоваться моделью для изучения закономерностей в ваших данных. Затем вы можете добавить новые условия (наблюдения) и она предскажет результат!
Определение машинного обучения с учителем
Обучение с учителем — это тип машинного обучения, в котором данные, которые вы засовываете в модель «помечаются». Пометка просто означает, что результат наблюдения (то есть ряд данных) известен. Например, если ваша модель пытается предсказать пойдут ли ваши друзья играть в гольф или нет, у вас могут быть такие переменные, как погода, день недели и так далее. Если ваши данные помечены, то ваша переменная будет иметь значение 1, в том случае если ваши друзья пошли играть в гольф, и значение 0, если они не пошли.
Определение машинного обучения без учителя
Как вы наверно могли угадать, когда речь идет о помеченных данных, обучение без учителя является противоположностью обучения с учителем. В обучении без учителя, вы не можете знать пошли ваши друзья играть в гольф или нет – только компьютер может найти закономерности с помощью модели, чтобы угадать, что уже произошло или предсказать, что произойдет.
Модели Машинного Обучения С Учителем
[Требуется присутствие взрослых]
Логистическая регрессия
Логистическая регрессия используется для решения проблемы классификации. Это значит, что ваша целевая переменная (та которую вы хотите предсказать) состоит из категорий. Эти категории могут быть да/нет, или что-то вроде числа от 1 до 10, которое обозначает удовлетворенность клиента. Модель логистической регрессии использует уравнение, чтобы создать кривую с вашими данными, а затем использует эту кривую, чтобы спрогнозировать результаты нового наблюдения.
Illustration of Logistic Regression
На графике выше, новое наблюдение получило бы в прогнозе 0, потому что оно попадает на левую часть кривой. Если посмотреть на данные, по которым построена кривая, это логично, потому что в области графика «прогнозируемое значение 0» большинство точек по оси y имеют значение 0.
Линейная Регрессия
Довольно часто линейная регрессия становится первой моделью машинного обучения, которую люди изучают. Связано это с тем, что ее алгоритм (проще говоря уравнение) достаточно просто понять, используя только одну переменную x – вы просто-напросто рисуете наиболее подходящую линию – концепция, которой учат еще в начальной школе. Наиболее подходящая линия затем используется для прогнозирования новых точек данных (см. иллюстрацию).
Illustration of Linear Regression
Линейная Регрессия чем-то напоминает логистическую регрессию, но используется, когда целевая переменная – непрерывная, а это значит, что она может принимать практически любое числовое значение. На самом деле, любая модель с непрерывной целевой переменной может быть классифицирована как «регрессия». Примером непрерывной переменной может служить цена продажи дома.
Линейная регрессия хорошо интерпретируется. Уравнение модели содержит коэффициенты для каждой переменной, и эти коэффициенты показывают, насколько сильно меняется целевая переменная при малейшем изменении независимой переменной (х-переменной). Если показывать это на примере цен на продажу дома, это означает, что вы могли бы посмотреть на уравнение регрессии и сказать что-то типа «о, это говорит мне о том, что за каждый дополнительный 1м2 от размера дома (х-переменная), цена продажи (целевая переменная) увеличивается на $25.»
K Ближайших Соседей (KNN)
Эта модель может быть использована для классификации или для регрессии. Название — «К Ближайших Соседей» не должно сбить вас с толку. Для начала модель выводит все данные на график. Часть «К» в названии относится к числу ближайших соседних точек данных, на которые модель смотрит, чтобы определить каким должно быть прогнозное значение (см. иллюстрацию ниже). Вы, как будущий data science специалист, выбираете значение K и можете поиграть с ним, чтобы увидеть, какое из значений дает лучшие прогнозы.
Illustration of K Nearest Neighbors
Все точки данных, находящиеся в круге K=__, получают “голос » относительно того, каким должно быть значение целевой переменной для этой новой точки данных. Значение, которое получает большинство голосов – это значение, которое KNN прогнозирует для новой точки данных. В иллюстрации выше, 2 ближайших соседей – class 1, в то время как 1 соседей – class 2. Таким образом, модель бы спрогнозировала class 1 для этой точки данных. Если модель предсказывает числовое значение, а не категорию, то все «голоса» — числовые значения, которые усредняются, чтобы получить прогноз.
Метод опорных Векторов (SVMs)
Принцип работы опорных векторов заключается в том, что они устанавливают границы между точками данных, где большинство из одного класса падает на одну сторону границы (как пример, в двумерном пространстве это будет линия) и большинство из другого класса падает на другую сторону границы.
Illustration of Support Vector Machines
Способ работы также заключается в том, что машина стремится найти границу с наибольшим пределом. Предел определяется расстоянием между границей и ближайшими точками каждого класса (см. иллюстрацию). Новые точки данных затем строятся и помещаются в определенный класс, в зависимости от того, на какую сторону границы они попадают.
Я объясняю эту модель на примере классификации, но вы также можете ее использовать для регрессии!
Деревья Решений & Случайные Леса
Про это я уже рассказывала в предыдущей статья, вы можете найти ее здесь (Деревья Решений и Случайные Леса ближе к концу):
Модели Машинного Обучения Без Учителя
[Читайте с осторожностью]
Теперь мы готовы перейти к машинному обучению без учителя. Напомню, это значит, что наш датасет не помеченный, так что мы не знаем результаты наших наблюдений.
K Значит Кластеризация
Когда вы используете K кластеризацию, вы должны начать с предположения, что в вашем датасете присутствует K кластеров. Поскольку вы не знаете, сколько групп на самом деле в ваших данных, вы должны попробовать различные значения K и с помощью визуализации и метрик понять, какое значение K подходит. Метод K средних лучше всего работает с круговыми кластерами одинаковых размеров.
Этот алгоритм сначала выбирает лучшие точки данных K, чтобы сформировать центр каждого K кластера. Затем, он повторяет 2 следующих шага для каждой точки:
1. Присваивает точку данных ближайшему центру кластера
2. Создает новый центр, взяв среднее значение всех точек данных из этого кластера
Все модели машинного обучения за 5 минут
Все модели машинного обучения разделяются на обучение с учителем (supervised) и без учителя (unsupervised). В первую категорию входят регрессионная и классификационная модели. Рассмотрим значения этих терминов и входящие в эти категории модели.
Обучение с учителем
Представляет собой изучение функции, которая преобразует входные данные в выходные на основе примеров пар ввода-вывода.
Например, из набора данных с двумя переменными: возраст (входные данные) и рост (выходные данные), можно реализовать модель обучения для прогнозирования роста человека на основе его возраста.
Пример обучения с учителем
Повторюсь, обучение с учителем подразделяется на две подкатегории: регрессия и классификация.
Регрессия
В регрессионных моделях вывод является непрерывным. Ниже приведены некоторые из наиболее распространенных типов регрессионных моделей.
Линейная регрессия
Пример линейной регрессии
Задача линейной регрессии заключается в нахождении линии, которая наилучшим образом соответствует данным. Расширения линейной регрессии включают множественную линейную регрессию (например, поиск наиболее подходящей плоскости) и полиномиальную регрессию (например, поиск наиболее подходящей кривой).
Дерево решений
Изображение из Kaggle
Дерево решений — популярная модель, используемая в исследовании операций, стратегическом планировании и машинном обучении. Каждый прямоугольник выше называется узлом. Чем больше узлов, тем более точным будет дерево решений. Последние узлы, в которых принимается решение, называются листьями дерева. Деревья решений интуитивны и просты в создании, однако не предоставляют точные результаты.
Случайный лес
Случайный лес — это техника ансамбля методов, основанная на деревьях решений. Случайные леса включают создание нескольких деревьев решений с использованием первоначальных наборов данных и случайный выбор поднабора переменных на каждом этапе. Затем модель выбирает моду (значение, которое встречается чаще других) из всех прогнозов каждого дерева решений. Какой в этом смысл? Модель “победы большинства” снижает риск ошибки отдельного дерева.
Например, у нас есть одно дерево решений (третье), которое предсказывает 0. Однако если полагаться на моду всех 4 деревьев, прогнозируемое значение будет равно 1. В этом заключается преимущество случайных лесов.
Нейронная сеть
Визуальное представление нейронной сети
Нейронная сеть — это многослойная модель, устроенная по системе человеческого мозга. Как и нейроны в нашем мозге, круги выше представляют узлы. Синим обозначен слой входных данных, черным — скрытые слои, а зеленым — слой выходных данных. Каждый узел в скрытых слоях представляет функцию, через которую проходят входные данные, приводящие к выходу в зеленых кругах.
Классификация
В классификационных моделях вывод является дискретным. Ниже приведены некоторые из наиболее распространенных типов классификационных моделей.
Логистическая регрессия
Логистическая регрессия аналогична линейной регрессии, но используется для моделирования вероятности ограниченного числа результатов, обычно двух. Логистическое уравнение создается таким образом, что выходные значения могут находиться только между 0 и 1:
Метод опорных векторов
Метод опорных векторов — это классификационный метод обучения с учителем, довольно сложный, но достаточно интуитивный на базовом уровне.
Предположим, что существует два класса данных. Метод опорных векторов находит гиперплоскость или границу между двумя классами данных, которая максимизирует разницу между двумя классами. Есть множество плоскостей, которые могут разделить два класса, но только одна из них максимизирует разницу или расстояние между классами.
Наивный Байес
Наивный Байес — еще один популярный классификатор, используемый в науке о данных. Его идея лежит в основе теоремы Байеса:
Несмотря на ряд нереалистичных предположений, сделанных в отношении наивного Байеса (отсюда и название “наивный”), он не только доказал свою эффективность в большинстве случаев, но и относительно прост в построении.
Обучение без учителя
В отличие от обучения с учителем, обучение без учителя используется для того, чтобы сделать выводы и найти шаблоны из входных данных без отсылок на помеченные результаты. Два основных метода, используемых в обучении без учителя, включают кластеризацию и снижение размерности.
Кластеризация
Кластеризация — это техника обучения без учителя, которая включает в себя группирование или кластеризацию точек данных. Чаще всего она используется для сегментации потребителей, выявления мошенничества и классификации документов.
Распространенные методы кластеризации включают кластеризацию с помощью k-средних, иерархическую кластеризацию, сдвиг среднего значения и кластеризацию на основе плотности. У каждого из них есть свой способ поиска кластеров, однако все они предназначены для достижения одного результата.
Понижение размерности
Снижение размерности — это процесс уменьшения числа рассматриваемых случайных переменных путем получения набора главных переменных. Проще говоря, это процесс уменьшения размера набора признаков (уменьшение количества признаков). Большинство методов снижения размерности могут быть классифицированы как отбор или извлечение признаков.
Популярный метод понижения размерности называется методом главных компонент (PCA). Он представляет собой проецирование многомерных данных (например, 3 измерения) в меньшее пространство (например, 2 измерения). Это приводит к уменьшению размерности данных (2 измерения вместо 3) при сохранении всех исходных переменных в модели.
- Машинное обучение. С чего начать? Часть 1
- Я хочу изучать AI и машинное обучение. С чего мне начать?
- Максимальная производительность Pandas Python
Жизненный цикл ML-модели
Всем привет! Меня зовут Максим, и в Ситимобил я занимаюсь машинным обучением. Сегодня я расскажу вам, как мы разрабатываем устойчивые ML-модели в суровых условиях изменчивого мира.

Зачем моделям нужен жизненный цикл
Будем называть ML-моделью объект, возвращающий прогноз для входящего набора признаков. Пусть для простоты это будет модель бинарной классификации.
Представим, что модель уже разработана, метрика на out of time выборке (отложенной во времени) нас устраивает, и мы выкатываем модель в production. Получаем положительный результат в первый месяц работы, но потом качество сильно падает. Сколько нужно ждать, прежде чем предпринимать какие-либо действия в отношении модели? Стоит ли сразу же пытаться актуализировать её или же подождать, так как через день-два метрики снова станут стабильными? В идеальном мире ответ должен быть до развёртывания в production. И жизненный цикл поможет нам ответить на этот и другие вопросы по работе модели.
Когда вы начнёте искать информацию по планированию жизненного цикла модели, в большинстве случаев найдёте статьи по поддержке существующего алгоритма переобучения средствами DevOps и MLOps. Но как сделать алгоритм, который нужно поддерживать, переобучать и валидировать?
Принципы разработки жизненного цикла модели
Чтобы модель стабильно работала в будущем, нужно на этапе разработки эмулировать её работу на достаточно большом наборе данных. На каждой итерации можно менять один или несколько параметров. Этот процесс напоминает классический подбор гиперпараметров, поэтому нам нужно точно оценивать результат каждой отдельной симуляции по целевой метрике. Только в нашем случае гиперпараметры не типизированы и мы сами решаем, что именно менять в каждой конфигурации.

Какие параметры нужно учитывать, чтобы оценить жизненный цикл:
- периодичность переобучения модели;
- необходимый объём обучающей выборки;
- поведение целевой метрики во времени в стабильных и экстремальных условиях;
- как учитывать различные смещения целевой переменной и модельных признаков;
- прочие вопросы, характерные для отрасли применения модели.
Рассмотрим отдельно каждый из этих пунктов.
Периодичность переобучения модели
Так как мир не стоит на месте и всё постоянно меняется, модель может устаревать и терять качество (в единицах целевой метрики). Поэтому нужно проверить, через сколько часов, дней, месяцев качество начинает ухудшаться. Для этого мы проводим симуляцию, в которой движемся скользящим окном по всем доступным датам и оцениваем модель на несколько интервалов вперед.
Так мы сможем оценить потенциальное ухудшение качества модели во времени и принять решение о частоте её переобучения.
Оценка объема обучающей выборки
По аналогии с изменением объёма тестовых данных мы можем менять объём обучающей выборки. Мотивация может быть разная:
- на небольшом промежутке времени на обучающей выборке модель может переобучиться;
- в распределении целевой переменной есть сезонность;
- модель вносит смещение в распределение целевой переменной;
- объёма данных может быть недостаточно для выявления ключевых зависимостей.
Чтобы понять, сколько данных нам достаточно для стабильной работы модели, нужно также пройтись скользящим окном по доступным датам, но уже в обратную сторону, постепенно увеличивая обучающий набор данных.
Итогом этой симуляции будет n оценок модели на одном и том же наборе тестовых данных, что позволит точно понять, какая конфигурация оказалась лучшей.
Изменение распределения целевой переменной
Часто бывает так, что поведение целевой переменной нестабильно во времени. Ещё больше нестабильности вносит тот факт, что модель прямо влияет на её распределение (в нашем примере).
Здесь видно, как зона распределения условной целевой переменной постепенно увеличивается с течением времени. Это означает, что применение ML-модели в новой области, которой не было в обучающей выборке, может быть непредсказуемо.
Частично эту проблему должно решать правило частоты переобучения модели. Но ещё на этапе моделирования мы можем оценить влияние нестабильного поведения предсказываемой переменной на целевую метрику. Для этого нужно провести симуляцию, в которой мы искусственно будем уменьшать или увеличивать на n% баланс положительного класса. Таким образом мы сможем сделать выводы о стабильности нашего жизненного цикла при нетипичном изменении (таком, которого не было в обучающей выборке) целевой переменной.
Прочие отраслевые вопросы
Самый простой пример: а что будет, если бизнес нашей компании вырастет на 20 % за n дней? Останется ли наш алгоритм стабильным, если завтра все входные признаки для модели увеличатся или уменьшатся на 20 %?
Алгоритм проверки аналогичен тому, что описан выше. Проводим симуляцию и проверяем, как увеличение или уменьшение того или иного признака влияет на стабильность целевой метрики. Если она ухудшается, то, возможно, стоит ещё раз пересмотреть частоту переобучения модели.
Все названные параметры могут как зависеть друг о друга, так и быть независимыми. Поэтому следует учитывать это при симуляции жизненного цикла. Идеальным решением подбора конфигурации будет оптимизация всех параметров сразу по сетке (как это происходит при подборе классических гиперпараметров).
Мы разработали правила жизненного цикла, что дальше?
Вот мы и получили набор правил работы ML-модели. Половина дела сделана, осталось запустить жизненный цикл в production и мониторить его работу.
Поскольку ещё на этапе моделирования мы предусмотрели большинство но не все потенциальных проблем, то можно ожидать стабильной работы модели некоторе время без внешнего вмешательства.
P.S. Проводя симуляции, не забывайте фиксировать random seed!